Treść wpisu
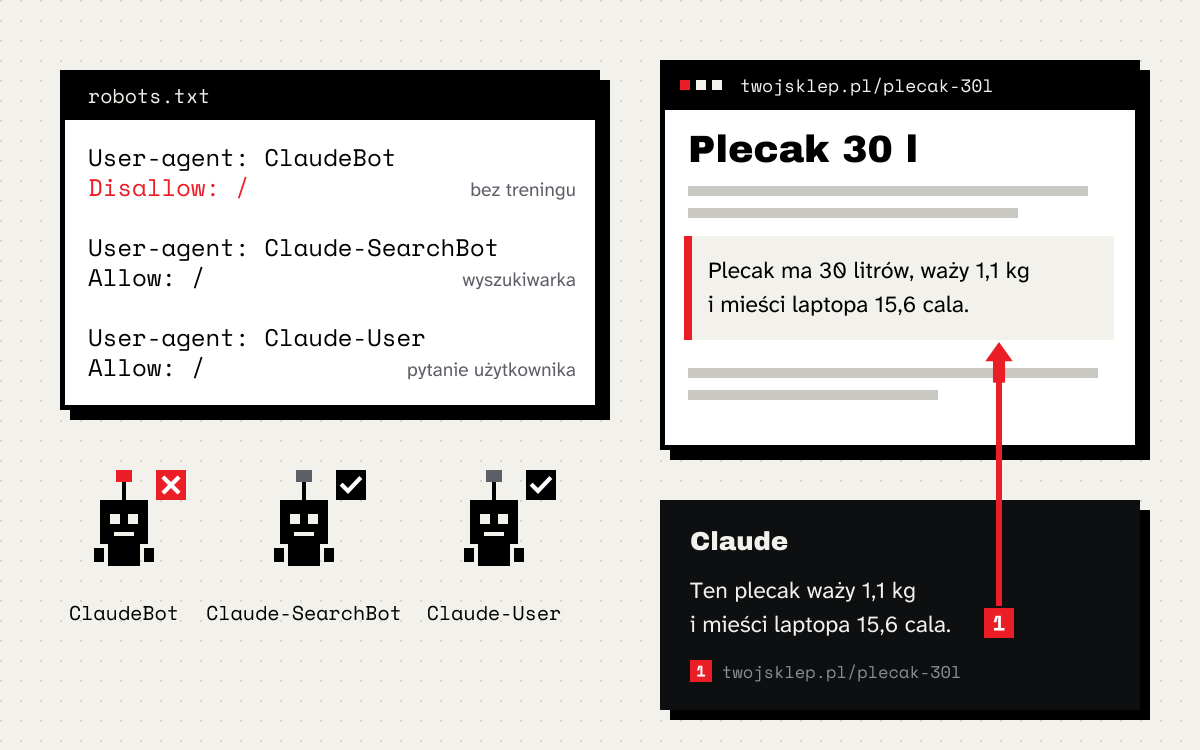
Claude trafia na Twoją stronę na dwa sposoby. Pierwszy to dane, na których Anthropic trenuje modele. Drugi to wyszukiwanie na żywo: użytkownik zadaje pytanie, Claude szuka w sieci, czyta kilka stron i odpowiada z cytowaniami. Ten drugi sposób daje ruch i polecenia już dziś, więc od niego zaczynam.
Wszystko, co piszę o botach, sprawdziłem w dokumentacji Anthropic. Linki są w tekście i w źródłach pod wpisem.
Jak Claude szuka w internecie
Gdy w Claude działa wyszukiwanie, Claude sam decyduje, kiedy sięgnąć do sieci. Według pomocy Anthropic każda taka odpowiedź ma cytowania, czyli linki do stron, z których Claude wziął informacje. To jest miejsce, w którym chcesz się znaleźć.
Skąd Claude bierze listę stron do przeczytania? W marcu 2025 Anthropic dopisał Brave Search do listy swoich podwykonawców, a Simon Willison sprawdził, że cytowania w Claude pokrywały się z wynikami Brave dla tego samego zapytania. Opisał to też TechCrunch. Anthropic nie publikuje, jak dokładnie dobiera źródła, więc traktuj to jako wskazówkę, a nie przepis. Wniosek praktyczny jest prosty: sprawdź, jak Twoja strona wypada w Brave Search na zapytania, które są dla Ciebie ważne.
Trzy boty Anthropic
Anthropic opisuje trzy boty w artykule o crawlowaniu. Każdy robi co innego, więc każdy wymaga osobnej decyzji.
| Bot | Do czego służy | Co się stanie, gdy go zablokujesz |
|---|---|---|
ClaudeBot |
Zbiera publiczne treści, które mogą trafić do trenowania modeli | Nowe treści z Twojej strony nie trafią do danych treningowych |
Claude-SearchBot |
Indeksuje strony, żeby poprawić wyniki wyszukiwania w Claude | Strona może rzadziej i mniej trafnie pojawiać się w odpowiedziach z wyszukiwania |
Claude-User |
Pobiera stronę, gdy użytkownik zada pytanie, które tego wymaga | Claude nie przeczyta strony, nawet gdy użytkownik o nią poprosi |
Co jeszcze warto wiedzieć z tej samej dokumentacji:
- Boty Anthropic respektują robots.txt.
- Anthropic obsługuje niestandardową dyrektywę
Crawl-delay, jeśli chcesz spowolnić wizyty botów. - Plik robots.txt działa osobno dla każdej subdomeny, więc
sklep.example.plpotrzebuje własnego. - Adresy IP botów są publikowane w pliku claude.com/crawling/bots.json. Anthropic odradza blokowanie po IP, bo wtedy boty mogą nie odczytać Twojego robots.txt.
robots.txt: trzy decyzje zamiast jednej
Najczęstszy błąd, jaki widzę, to jedna reguła dla wszystkich botów AI. Zablokowanie treningu jest w porządku, jeśli tego chcesz. Zablokowanie wyszukiwania wycina Cię z odpowiedzi, a to już decyzja o utracie ruchu.
Jeśli chcesz być w odpowiedziach Claude, ale nie chcesz, żeby Twoje treści trafiały do treningu, robots.txt może wyglądać tak:
User-agent: ClaudeBot
Disallow: /

User-agent: Claude-SearchBot
Allow: /

User-agent: Claude-User
Allow: /
Jeśli nie masz nic przeciwko treningowi, wystarczy nie blokować żadnego z nich. Na tej stronie wpuszczam wszystkie trzy, bo sprzedaję widoczność w AI i sam muszę być widoczny. Mój plik możesz podejrzeć pod deadnet.pl/robots.txt.
Dwie rzeczy, które psują to po cichu:
- Firewall i CDN. Jeśli strona stoi za Cloudflare albo innym CDN, sprawdź ustawienia blokowania botów AI. Potrafią zablokować boty niezależnie od tego, co masz w robots.txt. Przy wdrażaniu tej strony pilnowałem, żeby zarządzany robots.txt w Cloudflare nie nadpisał mojego pliku.
- Wtyczki SEO. Niektóre wtyczki do CMS same dopisują reguły dla botów AI. Zajrzyj do gotowego pliku pod adresem
/robots.txt, bo ustawienia wtyczki nie pokazują wszystkiego.
llms.txt: tani dodatek, nie warunek
Plik llms.txt to propozycja Jeremy’ego Howarda z września 2024 roku. To plik Markdown w katalogu głównym strony: nazwa strony w nagłówku, krótki opis w cytacie i listy linków do najważniejszych podstron.
Anthropic w dokumentacji crawlerów nie pisze, że Claude z niego korzysta. Google pisze wprost, że do AI Overviews nie potrzebujesz żadnych plików tekstowych dla AI. Ja mam llms.txt na tej stronie, bo generuje się sam z treści i nic nie kosztuje. Nie licz jednak, że sam plik coś zmieni. Liczy się to, co jest na stronach, do których prowadzi.
Treść, którą da się zacytować
Claude czyta kilka stron i składa z nich odpowiedź. Cytuje te fragmenty, które da się wyjąć z kontekstu i które nadal mają sens. Kilka zasad, które stosuję u klientów:
- Definicja na górze. Pierwsze zdanie strony usługi albo kategorii mówi, czym to jest. „Audyt SEO to przegląd serwisu pod kątem technicznym, treści i linków” da się zacytować. „Witamy w naszym sklepie” nie.
- Akapit, który stoi sam. Jeden akapit, jedna odpowiedź, bez odwołań typu „jak wspomnieliśmy wyżej”.
- Liczby z jednostkami. Porównaj dwa zdania. „Nasz plecak to idealny wybór na każdą wyprawę.” „Plecak ma 30 litrów pojemności, waży 1,1 kg i mieści laptopa 15,6 cala.” Drugie zdanie odpowiada na konkretne pytanie, więc ma szansę trafić do odpowiedzi.
- Nagłówki jak pytania klientów. „Ile kosztuje przegląd dachu dronem” zamiast „Cennik”.
- Autor i daty. Kto napisał, kiedy opublikował i kiedy zaktualizował. Ten wpis ma obie daty pod tytułem.
Jedna rzecz technicza, ważna dla sklepów na PWA i headless: w dokumentacji Anthropic nie znalazłem informacji, czy boty uruchamiają JavaScript. Bezpieczniej założyć, że nie. Jeśli opis produktu pojawia się dopiero po wykonaniu skryptu, bot może zobaczyć pustą stronę. Sprawdzisz to, wyłączając JavaScript w przeglądarce albo pobierając stronę przez curl.
Dane strukturalne
Anthropic nie pisze, że Claude czyta JSON-LD. Dane strukturalne i tak warto mieć: porządkują fakty o firmie, produktach i autorach dla wyszukiwarek, a Claude korzysta z wyszukiwarek. Pilnuj tylko, żeby dane w JSON-LD zgadzały się z tym, co widać na stronie. Rozjazd między nimi to sygnał, że stronie nie można ufać.
Jak sprawdzić, czy Claude cytuje Twoją stronę
-
Zapytaj Claude. Spisz 10 do 20 pytań, na które Twoja strona powinna odpowiadać, i zadaj je Claude z włączonym wyszukiwaniem. Zapisz, kto jest cytowany. Powtarzaj co miesiąc na tej samej liście.
-
Przejrzyj logi serwera. Wizyty
Claude-SearchBotpokazują, które podstrony Claude indeksuje. WizytyClaude-Userto moment, w którym ktoś zadał pytanie, a Claude przyszedł po odpowiedź. Na serwerze z typowym logiem dostępu wystarczy:grep -E "ClaudeBot|Claude-SearchBot|Claude-User" access.log \ | awk '{print $7}' | sort | uniq -c | sort -rn | head -20Nazwę bota łatwo podrobić, więc przy ważnych decyzjach sprawdź IP z pliku
bots.json. -
Sprawdź analitykę. Wejścia z
claude.aito ludzie, którzy kliknęli cytowanie. Część przeglądarek nie przekazuje źródła, więc ta liczba będzie zaniżona. -
Sprawdź Brave. Wpisz te same pytania w Brave Search i zobacz, czy Twoja strona jest w wynikach.
Od czego zacząć
- Otwórz
/robots.txtna swojej stronie i sprawdź reguły dlaClaudeBot,Claude-SearchBotiClaude-User. - Sprawdź ustawienia botów AI w CDN i we wtyczkach SEO.
- Pobierz kilka ważnych podstron przez
curli zobacz, czy treść jest w HTML bez JavaScriptu. - Przepisz pierwsze akapity stron usług i kategorii tak, żeby dało się je zacytować.
- Spisz listę pytań i sprawdź, kogo Claude dziś cytuje zamiast Ciebie.
To pierwszy wpis z serii o widoczności w asystentach AI. Kolejne opisują Grok, ChatGPT, Perplexity oraz Gemini z AI Overviews.